只有累積,沒有奇蹟

顯示具有 Monitor 標籤的文章。 顯示所有文章

2023年3月12日 星期日

[APM] 提升應用程式效能的利器 Elastic APM : dotnet x Elastic

前言
這是 Elastic APM 的系列文第二篇,這篇文章將進入重點介紹 Elastic APM 與 dotnet 如何整合,如果想了解這篇系列文可以參考
  • APM 解決什麼問題
  • .NET x Elastic APM
  • OpenTelemetry x Elastic APM 整合
若對於上述內容有問題或是不清楚的地方,歡迎提出來一起討論


Elastic APM
Elastic Stack 過去大家比較聽過的可能是 Elasticsearch 功能,自己過去與幾位朋友的公司在此用 ELK 也是用得很開心。在這幾年可觀測性這議題國外開始陸續流行,Elastic 也推出完整的可觀測性解決方案 Elastic Observability,從官方對於 Elastic Observability 介紹如下
在過去 Elastic 提供強大的系統日誌功能,Elastic Search 搜尋引擎是基於文本的日誌方式進行搜索。在 2018 年開始 Elastic 開始推出 Elastic APM 功能,替開發人員與運維團隊添加了應用程式跟蹤與分布式跟蹤功能,Elastic APM 提供一組代理,用於支援的語言和框架收集跟追蹤 Log 資訊並支援其開源標準 OpenTracing,後來也開始支援新的遙測數據標準 OpenTelemetry,並與跟蹤數據與 Metrics、Log 數據相關聯,再加上監控 Monitor uptime tool 功能,將其資料分類最後透過 Kibana 與 ElasticSearch 提供 Dev & Ops 團隊盤查,讓團隊可以更了解系統的狀況。

Why Elastic APM
簡單介紹完 Elastic Observability 之後,接著想要在跟大家分享為什麼會推薦 Elastic APM 呢 ? 主要會有幾個原因分別是
  • Open source
  • Centralized Platform
  • Signals
接著針對這三點做簡單說明

Open source
這幾年 Open source 已經充斥在開發者的日常工作中,從開發到維運有各式各樣好用的工具都是開源的項目,自己覺得還有不錯的點是開發上不用重複造輪子,當今天需要某個功能時可能在 github 上就可以找到合適的解決方案,也越來越多大公司提供不同的 open source 解決方案,不用重新開發類似功能省下寶貴的時間。在團隊學習上,一些強大的開源項目在網路上有提供很多學習文件與教學,其學習資源是豐富的 (熱門專案),在學習或是問題發生時相對都有機會降低解決問題時間。另外在找人上也是有幫助,一些熱門的工具或是解決方案在很多公司都會使用,因此團隊遇到要擴編或是找新人時,在人力資源市場上都較容易找到其熟悉此框架的開發者。

Centralized Platform
根據 CNCF Observability Report 2020 報告有提到為了解決線上問題,要從不同的數據與角度來嘗試發現可能的問題,各自工具有不同的技術有個各自的優勢,但各工具中沒有辦法各自整合,在使用上或是盤查線上問題時需要在不同的工具中進行切換,在調查中可以看到有一半公司會使用 5 種或是更多工具,其中 1/3 會使用 10 種以上的工具經驗。團隊在不停的切換上無形中也浪費很多時間,因此如果可以在同個平台上觀看就可以省下這些時間,也有機會提供問題的處理速度與提升 MTTR。

Signals
公司產品或各團隊都會定義其服務的 SLA,提到 SLA 就必須定義 SLO (目標) 與 SLI(指標),在監控上這邊整理了幾個常見且重要的指標分別是 Golden Signals、Red 與 USE。Golden Signals 是由 google SRE book 所提出,關注的指標是 Latency、Traffic、Errors、Saturation。RED 與 USE 是 Golden Signals 的子集合 (面向稍微有些不同),RED 著重的是了解應用程式外部的狀況,USE 則是在了解應用程式 Infra 內部的狀況。三種方法分別有不同想要看的指標與方向,我這邊簡單整理主要會有五個重要的指標內容 (上圖 five signals 欄位),分別是
  • Request Rate : 每秒請求的量為何
  • Error Rate : 接收到這麼多請求錯誤率是多少
  • Latency : 回應速度是不是正常的
  • Saturation : 系統撐不撐得住
  • Utilization : 系統有多忙碌
接著我們可以在回到 Elastic APM 可以看到其內建就支援這些重要的指標包含 Latency、Throughput (per second)、Failed rate、Time spend by spend time,對開發其維運人員是相當有幫助的,示意圖如下


另外在 Elastic APM 支援上述可觀測性三個重要的維度 Metrics、Logs 與 Traces,想要解決的出發點如下
  • Metrics : Do I have a problem ?
  • Traces : Where is the Problem
  • Logs : What is causing the problem
Metrics

Traces
Logs


How Elastic APM works
上面說明了為甚麼選擇/推薦 Elastic APM 之後,接著我們來看身為開發人員可能會想了解 Elastic APM 是如何整合既有的應用程式
如上圖所示 Elastic APM 一共分為四部分分別是 APM agents, Elastic APM integration, Elasticsearch 與 Kibana,可以透過在既有的程式語言中加上 Elastic APM 所支援程式語言的 package 套件,目前主流的程式語言都有支援,支援列表可以參考此 官方文件,應用程式在運行時就會自動將數據資料蒐集送到 APM Server 中,可以分為五個步驟 分別是 設定 fleet、配置 Elastic APM、安裝 Elastic Agent、安裝 APM Agent 與 測試並查看結果。 在 Elastic 官方文件有其詳細的圖文並茂安裝步驟說明,這邊僅針對開發者較為相關的第四步驟進行解說,我們來看如果在 dotnet core 專案上要如何進行相關設定

安裝套件
開啟 nuget 並搜尋 Elastic.Apm.NetCoreAll,進行套件下載與安裝

應用程式加入代理
開啟 ASP.NET Core 應用程式,在專案 startup.cs 加上 app.UseAllElasticApm(Configuration) 方法

public class Startup
{
  public void Configure(IApplicationBuilder app, IHostingEnvironment env)
  {
    app.UseAllElasticApm(Configuration);
  }
}
  

配置組態檔
在 config 設定 服務名稱、APM Server URL 以及 Secret Token 等資訊,如下圖所示
{
    "ElasticApm": {
    "SecretToken": "",
    "ServerUrls": "http://localhost:8200", //Set custom APM Server URL (default: http://localhost:8200)
    "ServiceName" : "MyApp", //allowed characters: a-z, A-Z, 0-9, -, _, and space. Default is the entry assembly of the application
  }
}
  
上述提到都是基本(最小化)設定參數,在 Elastic APM 還支援多種配置設定像是環境變數(environment)、斷路器設定(circuit_breaker_enable) 及採集率(transaction_sample_rate),採集率可以設定是否需要蒐集每筆交易,以降低開銷與 storage 空間,其值可以設定 0.0~1.0 之間,根據你的需求來定義請求的採集率。如果環境有要架設可以參考官方提供的 docker file 來建立其環境。
以上為簡單的說明 Elastic APM 如何與您的應用程式做整合的動作,如果你想看一下整合的結果測試,可以參考 Elastic APM 預設 Demo 的網站。裡面有測試資料可以讓你了解 Elastic APM 的強大之處。
此篇也差不多進入尾聲,今天介紹了 Elastic x APM 彼此怎麼整合,希望可以透過這篇分享能夠了解到基本上的應用,下一篇則是來介紹 Elastic APM 與 OpenTelemetry 如何進行整合。


參考
apm-quick-start

2022年12月28日 星期三

[APM] 提升應用程式效能的利器 Elastic APM : APM 解決什麼問題

前言
資深的開發者都知道程式開發完成後上線後是個重大的挑戰,隨著功能的迭代系統功能會變得更複雜,如何確保當程式錯誤時可以更快速的 debug 與找到異常的問題或出問題的服務 (Service)是個重要的議題,因此自己在可觀測性如何落地過程中 suvery 很多不同工具發現 Elastic APM 是符合需求的,另外也支援近期火紅的 OpenTelemetry 蒐集遙測數據的開源框架,接著會預計整理成相關系列文章。這邊是研究 Elastic APM 的系列文第一篇,這系列主要會分為三篇分別是
  • APM 解決什麼問題
  • .NET x Elastic APM
  • OpenTelemetry x Elastic APM 整合
若對於上述內容有問題或是不清楚的地方,歡迎提出來一起討論


真實世界的問題
如果自己公司產品或是系統在 PRODUCTION 環境壞掉會怎麼辦呢 ? 公司產品可能是電商系統,亦或者是演唱會在搶票或是 HR 產業上下班打卡的情境,這時候身為開發者或是資深工程師的你們,要如何找到可能的問題呢 ?
這時候我們可以問一下最近最夯的 chartGPT,身為一個不專業的工程師,請問線上網站壞掉了怎麼辦呢 ? chartGPT 的回答如下
這回答的重點是確認 Server 狀況、看 Log、尋找網站的維運人員來協助解決,但反過來說身為開發者的我們,當遇到緊急問題的時候要如何快速找到問題呢 ?
可能相對較完整的問題處理流程可能是如下圖所示
  • 透過監控與系統預警機制,設定水位與警報告知提醒有潛在的問題發生 (Metrics + Logging)
  • 當收到異常通知時,開啟監控 Dashboard 來釐清問題,使用常用的查詢與統計找到可能發生異常的模組 (Metrics)
  • 針對模組與相關程式碼 Log 查詢與分析其問題,找到異常的 Log 資訊 (Logging)
  • 定位可能的服務後,查詢其請求的鏈路追蹤定位問題代瑪 (Tracing)
可以發現在問題處理的流程中主要會透過 Metrics、Logging、Tracing 找到可能系統的異常問題,這也就是可觀測性一直以來提到的三個支柱觀念。在 2017 年時 Peter Bourgon 在 2017 Distributed Tracing Summit 後撰寫文章 Metrics, tracing, and logging,作者認為 Metrics 特徵是可以聚合的,Log 是處理離散的事件,Tracing 特徵是處理請求範圍的信息。三者在各自都有其功用與目的,如果缺少其中一項可能在對問題處理與時效上都會有些影響,並透過一張圖歸納三者的關聯與重疊部分,
如果對其有興趣想了解更多可以參考 連結,這裡不多加說明。


企業永續
上述處理問題的流程背後的目的想要解決的是企業永續經營(Business Continuity),企業永續經營是個目標聽起來很遙遠那要怎麼達到呢 ? 可以透過企業永續經營企劃(Business continuity planning)來達到其目的,針對 BCP WIKI 說明如下
Any event that could negatively impact operations should be included in the plan, such as supply chain interruption, loss of or damage to critical infrastructure (major machinery or computing/network resource). As such, BCP is a subset of risk management.
A Business Continuity Plan outlines a range of disaster scenarios and the steps the business will take in any particular scenario to return to regular trade. 
BCP's are written ahead of time and can also include precautions to be put in place.
這聽起來有點高大尚離我們很遙遠,就我自己的理解就是制定其計畫,計畫內容是當意外發生的時候企業可以針對關鍵的流程快速恢復服務,降低意外發生時後對企業營運的影響。可以分為四個流程
  • 識別企業關鍵流程與資源
  • 確認關鍵流程的影響
  • 定義解決方案
  • 方案進行演練
實作上可以思考 Backup、Disaster Recovery、High Availability 三個方向(包含但不限),以下就自己的理解做簡單的說明
  • Backup : 不管傳統的機房或是雲端,企業重要資料都是需要備份 不然遭遇到天災時 應用程式重新佈署可以使用 但資料無法復原會是很尷尬的問題
  • 災難備援 :要思考的是當災難發生時,要如何在最短的時間將網站快速恢復,網站佈署即恢復的流程怎麼進行、團隊分工分別是什麼、定期演練的規劃,當異常發生時接受噴掉多少資料及多久能恢復都是關鍵的問題與需要事前準備的。
  • High Availability : 為了要達到系統的高可用性,要如何做好監控機制、告警機制如何通知、處理人員及異常事件處理流程與 SOP 分別是甚麼,最後產品的 SLA、SLO與 SLI 要怎麼定義,這些都是重要的考量與因素。
其中 SLA、SLO、SLI 的部分是很重要的一個環節,SLA 是產品與客戶的協議合約,SLO 要達到 SLA 是我產品所制定的目標,SLI 要達到目標所定義的指標,要先有辦法衡量才可以進行其管理與改善,才有機會知道我們做完了某些決策之後,是不是有變好進行下一步的調整方向。SLA 內容可以參考 .NET MVP 安德魯大師之前在 .NET Conf 2020 的分享,裡面有清楚定義三者關係,影片連結 Andrew Wu - 非同步系統的服務水準保證;淺談非同步系統的 SLO 設計 。


APM
接著進入這篇的重點 APM,什麼是 APM 呢 ? 一般來說有兩種定義分別是 Application Performance Monitoring 與 Application Performance Management,前者是後者的集合。APM 的目的可以幫助開發團隊在應用程式遭遇到錯誤或是異常問題時,快速的將問題定問與修復,縮短其平均修復時間(MTTR),達到前面所提到的企業永續經營裡高可用性(HA)的目的。當然上述只是其中一個目的還可以幫助很多不同的面相,在 What is APM? Application performance monitoring guide 就有提到還可以解決以下問題
  • 整合 APM 到整個網絡監控和管理工具中
  • 確保應用程式 response 時間和用戶體驗
  • 增加應用程式的正常運行時間/減少中斷時間
  • 實施服務保障方法和服務水平均協議(SLA)
  • 蒐集應用程式效能與元件/底層資訊
重點是希望透過 APM 來提高開發人員對於系統的了解 (Observability) 與縮短 MTTR (Mean Time to revocer)。
在 CNCF Landscape 有針對可觀測性 Observability 列出滿滿的專案,大致上分為 Monitor、Logging、Tracing、Chaos Engineer 與 Continuous Optimization 等各式各樣的專案與工具,其中要推薦的 Elastic APM 就是在其中之一,關於其介紹會在下一篇在說明 :)


參考
Metrics, tracing, and logging
Andrew Wu - 非同步系統的服務水準保證;淺談非同步系統的 SLO 設計

2022年1月26日 星期三

[OpenTelemetry] 現代化監控使用 OpenTelemetry 實現 : 在 .NET 如何使用 OpenTelemetry

前言
最近在 suvery 監控相關議題時接觸到 OpenTelemetry 蒐集遙測數據的開源框架,覺得這議題挺有趣的因此整理變成系列文,這篇是研究 OpenTelemetry 的系列文第三篇, 這系列主要會分為四篇分別是 若對於上述內容有問題或是不清楚的地方,歡迎提出來一起討論

OpenTelemetry in .NET
在前面分別提到了甚麼是可觀測性 (Observability) 以及 OpenTelemetry 蒐集遙測數據的規範標準,在 OpenTelemetry 在多種主流的程式語言都有實作,這邊就來分享在 .NET 中要如何使用 OpenTelemetry。在 OTel (OpenTelemetry簡稱)中 .NET Core 及 .NET Framework 都有支援(後者版本需高於 4.6.1),在 Github 位置是 opentelemetry-dotnet,與開發者最直接相關的為下列部分
  • API
  • SDK
  • Instrumentation libraries
  • Exporter libraries
以下分別針對個別項目做簡單介紹

API
Github : OpenTelemetry .NET API
可觀測性 (Observability) 中的三個重要元素 Tracing、Metrics、Logging 在 OTel dotnet 分別皆有實作,在支援的程度上除了 Tracing 是 1.0 之外,其他兩項分別還在 Alpha 與 Beta 階段。在 OTel dotnet 上提供 Tracing API, Logging API, Metrics API, Context and Propagation API 等 API 讓開發者依據各自需求作使用。

SDK
Github : OpenTelemetry .NET SDK
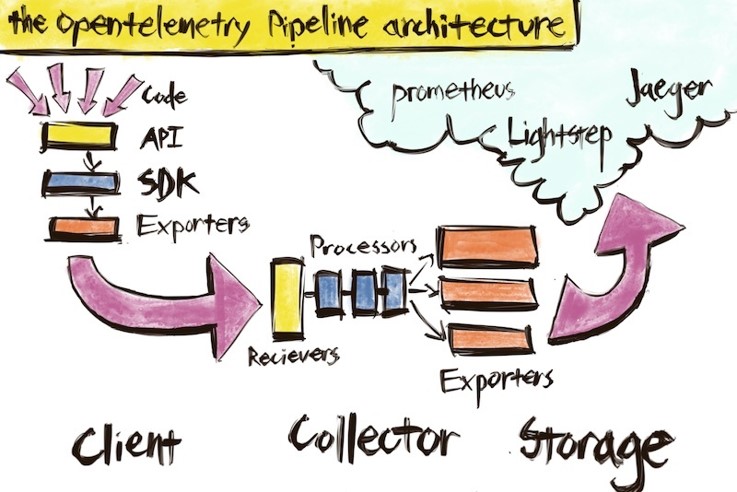
SDK 是 OTel API 的實現,目前 SDK 中實現了 Tracing API、Metrics API 和 Context API 等功能。當開發者使用與安裝配置的 SDK 後,所使用到的 API 方法將會開始生成、蒐集、發送遙測數據內容,並提供開發者自訂義 process pipleline 與導出到特定後端功能。目前 SDK 有與 ILogging 進行整合。

Instrumentation libraries
Github : OpenTelemetry .NET Instrumentation Library
提供常用的 Library 讓開發者在使用 OpenTelemetry 上更方便,像是 ASP.NET、ASP.NET Core、HttpClient、SQL Client 或是 SQL Client 等。你的應用程式代碼中如果有用到 httpclient 就可以引用其 OTel httpclient library,使用後就會自動蒐集生成遙測資料,開發者不用寫很多代碼即可達到其目的。目前在 dotnet 支援的 library 可以參考官方網站 OpenTelemetry registry 說明頁。

Exporter libraries
Github : OpenTelemetry .NET Exporter Library
蒐集遙測數據之後這些數據內容呈現的工具,像是在 Demo code 常使用的 console 或是 memory 中,亦或可以選擇 jaeger、zipkin、prometheus 等常見的工具,如果是在 Cloud 上在三大雲端服務廠商 AWS、Azure、GCP 也開始支援 OpenTelemetry 的輸出資料呈現。舉例來說在 Azure 上就可以透過 Azure Application Insights 以及 Azure Monitor 等服務查看蒐集到的資料呈現。

Package
Metrics
這裡列出在 .NET 中與 OpenTelemetry 會有相關的 namespace,其中 Instrumentation 與 Exporter 前面章節已經有提到過不在重複。在 .NET 6 之後的版本開始添加 OpenTelemetry 的支援。System.Diagnostics.Metrics 是 OpenTelemetry Metrics API 規範在 .NET 的實現,Meter 類別是在使用時須要先建立的物件與對象,在依據場景來使用所需要 Metrics 的指標與方法,在目前 Metrics API 支援以下幾個儀器類型
  • Counter : 計數器,可以使用 Add 方法來計算變化率或是總和
  • ObservableCounter : 與 Counter 類似,用於可觀察的儀器值 例如 CPU 時間(針對不同 Process、Task or 用戶模式)
  • ObservableGauge : 非相加值得可觀察儀器,例如當前室溫
  • Histogram : 繪製直方圖或計算百分位數的工具
或許對於上述描述的說明還有些模糊或是不清楚,在微軟 MSDN 文件有提到使用 Metrics 儀器的使用時機
  • 如果是計算內容是隨著時間增加的值 : 建議使用 Counter 與 ObservableCounter
  • 如果是計算時事物 : 建議使用 Histogram
  • 其他類像是業務指標、Cache 命中率、緩存大小 : 建議使用 ObservableGauge
詳細可以參考 MSDN Best practices when selecting an instrument type 文件說明

Tracing
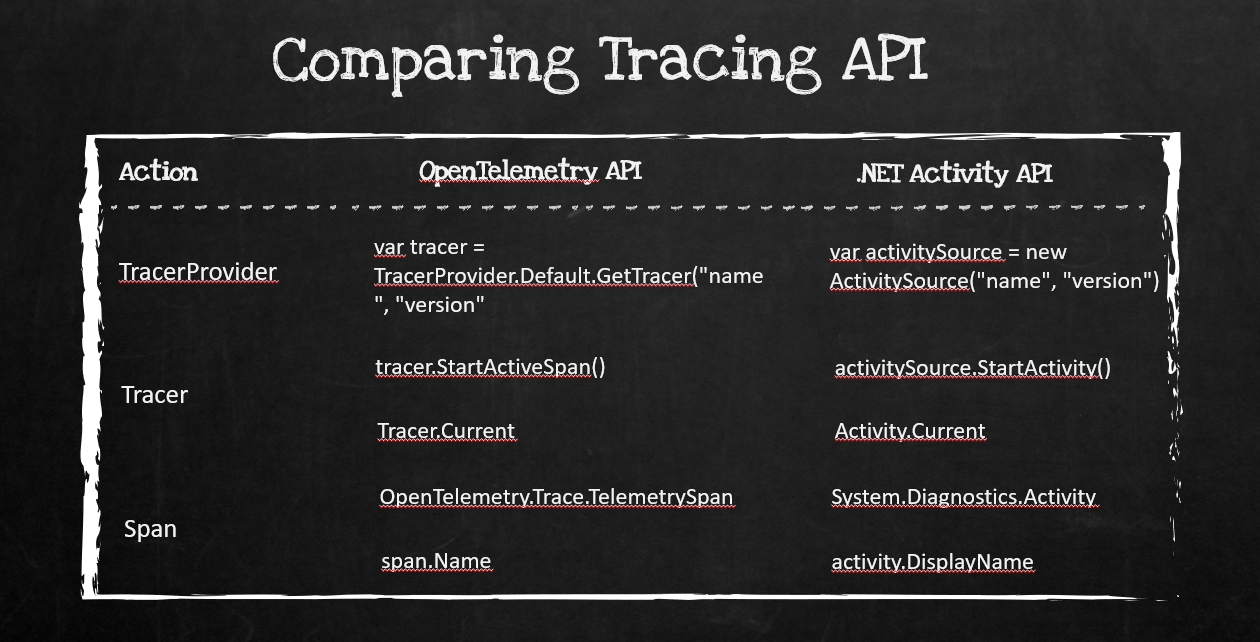
在 Trace 部分可以透過 .NET 內建類別 Activity 或是使用 OpenTelemetry Tracing API 都可以達到其目的,兩者使用後都會定義到 Span 概念。.NET 5 開始提供 Activity 的類別作為 tracing 追蹤的目的,建立實例後可以透過 StartActivity 啟動 Activity 並定義其追蹤名稱;在 OpenTelemetry API 也可以透過 Tracer 達到一樣的目的,透過 TracerProvider 建立實體後使用 StartActiveSpan 來定義追蹤物件。因此你可以發現在微軟官方的部落格或是 sample code 上都是使用內建的 Activity API 做完範例, 兩者的 API 比較差異可以參考上圖

今晚來點 Demo
以上講很多概念與 OpenTelemetry API 的介紹,接著我們就來針對些好玩的部分做 Demo 讓大家對於 OpenTelemetry 在 .NET 的應用更了解,每個 Demo Code 範例代碼皆已上傳到 Github 上,有興趣的朋友可以將 clone 下來自己執行試玩看看

Demo#1 : Console
source code : OpenTelemetrySample
第一個 Demo 開始透過簡單的 Console 作為起手式,在建立專案後請先引用 OpenTelemerey.NET SDK 及 OpenTelemerey.NET Exporter Console 相關 Package,相關指令如下
dotnet add package OpenTelemetry --version 1.1.0
dotnet add package OpenTelemetry.Exporter.Console --version 1.1.0
Program.cs 中進入點 main 程式碼如下
class Program
{
	private static readonly ActivitySource MyActivitySource = new ActivitySource("Company.Product.Library");

	public static void Main()
	{
		using var tracerProvider = Sdk.CreateTracerProviderBuilder()
			.SetResourceBuilder(ResourceBuilder.CreateDefault().AddService("SampleService"))
			.SetSampler(new AlwaysOnSampler())
			.AddSource("Company.Product.Library")
			.AddConsoleExporter()
			.Build();

		using (var activity = MyActivitySource.StartActivity("SayHello"))
		{
			activity?.SetTag("foo", 1);
			activity?.SetTag("bar", "NET Conf 2021, Hej !");
			activity?.SetTag("baz", new int[] { 1, 2, 3 });
		}
	}
}
程式碼說明
  • Line 3 : 建立 ActivitySource 物件,並定義名稱為 Company.Product.Library
  • Line 7 : 透過 SDK 建立 TracerProvider 物件並設定 Trace Service 的名稱為 SampleService
  • Line 9 : 設定 Sampler 採樣器配置設定為 alwaysOn
  • Line 10 : 定義 TraceProvider source 名稱為 Company.Product.Library (需要與 line 3 相同)
  • Line 11 : 設定 Exporter,這裡使用的是在 Console 輸出其結果
  • Line 14~19 : 設定 Actitity 物件並定義其 tag 的 key 與 value, ex : foo 值為 1
執行結果如下
除了上述程式碼的說明之外可以看到的是其中 activity 會自動蒐集其起始的時間 (startTime) 與花費時間 (Duration) 等在 trace 中重要的資訊,tagObject 也可以依據需求定義客製化的 attribute 或是屬性資訊,以上是簡單的範例一部分

Demo#2 : API
source code : OpenTelemetrySample.API
接著的範例是使用 API 的部分,在將範例的內容結果顯示在 Zipkin 工具上,因此在建立專案後請先引用 OpenTelemerey.NET SDK 及 OpenTelemerey.NET Exporter Console 及 OpenTelemetry.Exporter.Zipkin Package,相關指令如下
dotnet add package OpenTelemetry --version 1.1.0
dotnet add package OpenTelemetry.Exporter.Console --version 1.1.0
dotnet add package OpenTelemetry.Exporter.Zipkin --version 1.1.0
在這範例中會將蒐集到的遙測數據資料輸出到 Zipkin 中,Zipkin 是分散式追蹤的工具,可以幫助開發者在工具中以視覺化的方式了解到請求中哪一段緩慢的原因與百分比資訊,相關介紹可以透過 官網說明,快速使用方式可以透過 docker 在本機執行下列語法
docker run -d -p 9411:9411 openzipkin/zipkin
Program.cs 中進入點 main 程式碼如下
class Program
{
	private static readonly ActivitySource MyActivitySource = new ActivitySource("Company.Product.Library", "1.0");
	static void Main(string[] args)
	{
		using var tracerProvider = Sdk.CreateTracerProviderBuilder()
		   .SetResourceBuilder(ResourceBuilder.CreateDefault().AddService("MyService"))
		   .AddSource("Company.Product.Library")
		   .AddZipkinExporter(zipkinOptions =>
		   {
			   zipkinOptions.Endpoint = new Uri("http://localhost:9411/api/v2/spans");
		   })               
		   .AddConsoleExporter()
		   .Build();

		DoSomeWork();

		Console.WriteLine("Example work done"); 
	}

	static void DoSomeWork()
	{
		using (var a = MyActivitySource.StartActivity("SomeWork"))
		{
			StepOne();
			StepTwo();
		}

		using (var activity = MyActivitySource.StartActivity("StepThree", ActivityKind.Server))
		{
			activity?.SetTag("http.method", "GET");
			if (activity != null && activity.IsAllDataRequested == true)
			{
				activity.SetTag("http.url", "http://www.google.com");
				activity.SetTag("body", "This is a book");
			}
		}
	}

	static void StepOne()
	{
		using (var a = MyActivitySource.StartActivity("StepOne"))
		{
			Task.Delay(500);
		}
	}

	static void StepTwo()
	{
		using (var a = MyActivitySource.StartActivity("StepTwo"))
		{
			Task.Delay(1000);
		}
	}
}  
程式碼說明,其中有些與 Demo#1 相同的就不在重複說明唷
  • Line 7 : 設定 Service 的名稱為 MyService
  • Line 9 : 將遙測數據在 zipkin 上顯示,並定義輸出的 endpoint 為 http://localhost:9411/api/v2/spans
  • Line 23 : 定義 activity 物件名稱叫 Somework,其中執行 StepOne 與 StepTwo 兩個方法
  • Line 29 : 定義新的 activity 物件名稱為 StepThree,類型為 Server,內容模擬向第三方發出請求,因此會有定義 httpMethod、呼叫 endpoint 方法與送出 body 內容。
  • Line 40 : 定義 StepOne activity 物件,內容為 delay 500 毫秒
  • Line 48 : 定義 StepTwo activity 物件,內容為 delay 1 秒
執行結果如下
整理一下幾個重點
  • 順序為 StepOne > StepTwo > SomeWork > StepThree
  • StepOne 的 Id 為 StepTwo、SomeWork、StepThree 的 ParentId,上一篇提到的 Context Propagation 上下文關聯是透過此來定義
  • 每個 activity 會自動取得執行的 instance Id,這在雲端環境有這資訊很方便
  • 每個 Activity 皆有紀錄花費時間與起始時間
接著我們可以透過 zipkin 來看一下上面數據的視覺化呈現為和,開啟瀏覽器後輸入 http://localhost:9411/zipkin/ ,在按下 run query 按鈕

可以透過視覺化的方式來看到整個的關聯圖,已這個例子來說,Total Spans 一共三個,總共花費的時間為 60.288 ms,其中 stepOne 與 stepTwo 各自花費的時間,以及這兩個 span 中所各自定義的屬性是甚麼(右邊區塊),可以發現的是透過 zipkin 分散式追蹤工具在理解上更為清晰,如果在執行過程中有某個 span 是緩慢的可以更清楚的知道緩慢的原因與時間,那麼回到真實的世界會是甚麼樣子呢 ? 我們可以透過範例三知道。

Demo#3 : Automatic instrumentation
source code :
OpenTelemetrySample.WeatherForecast.Client
OpenTelemetrySample.WeatherForecast.API
在這範例中會透過較真實案例來說明,前端 Client 專案會透過 httpClient 呼叫後端 API 來取得 WeatherForecast 資訊,後端 API 會將資訊紀錄在 Redis 資料庫中,在亂數回 weather 資訊。我們會在這專案中引用自動蒐集遙測數據的 Library 像是 AddHttpClientInstrumentation,在發出 Httpclient 請求時自動蒐集相關遙測數據,並將其關聯結果呈現在 zipkin 工具上。
在 Client 專案的 Startup.cs 程式碼如下
public class Startup
{	
	public void ConfigureServices(IServiceCollection services)
	{
		services.AddControllersWithViews();

		services.AddOpenTelemetryTracing(Configuration);
	}

	public void Configure(IApplicationBuilder app, IWebHostEnvironment env)
    {
		//...省略
	}
	
	static class ServiceCollectionExtensions
    {

        public static IServiceCollection AddOpenTelemetryTracing(this IServiceCollection services, IConfiguration configuration)
        {
            var zipkinServiceName = configuration.GetValue("Zipkin:ServiceName");
            var zipkinEndpoint = configuration.GetValue("Zipkin:Endpoint");
            
            services.AddOpenTelemetryTracing((builder) => builder
                    .SetResourceBuilder(ResourceBuilder.CreateDefault().AddService(zipkinServiceName))
                    .AddAspNetCoreInstrumentation()
                    .AddHttpClientInstrumentation()
                    .AddZipkinExporter(zipkinOptions =>
                    {
                        zipkinOptions.Endpoint = new Uri($"{zipkinEndpoint}");
                    })
                    .AddConsoleExporter());

            return services;
        }
    }
}
程式碼說明
  • Line 7 : 在 ConfigureService 方法中加上 AddOpenTelemetryTracing 擴充方法
  • Line 20~21 : 取得 Config 設定檔中定義 zipkin 的 serviceName 與 endpoint
  • Line 25 : 將 OpenTelemerey 新增到 ASP.NET Core 應用程式中
  • Line 26 : 針對 httpclient 進行遙測數據的蒐集
  • Line 27 : 輸出到 zipkin 工具

另外,在 API 專案的 Startup.cs 程式碼如下
public class Startup
{	
	public void ConfigureServices(IServiceCollection services)
	{
		services.AddControllers();

		services.AddOpenTelemetryTracing(Configuration);

		services.AddStackExchangeRedisCache(options =>
		{
			options.InstanceName = "Redis Cache";
			options.Configuration = "localhost:6379";
		});
	}

	public void Configure(IApplicationBuilder app, IWebHostEnvironment env)
   {
		// 省略
	}	
	static class ServiceCollectionExtensions
    {

        public static IServiceCollection AddOpenTelemetryTracing(this IServiceCollection services, IConfiguration configuration)
        {
            var zipkinServiceName = configuration.GetValue("Zipkin:ServiceName");
            var zipkinEndpoint = configuration.GetValue("Zipkin:Endpoint");
            var redisEndpoint = configuration.GetValue("Redis:Endpoint");

            var connection = ConnectionMultiplexer.Connect(redisEndpoint);
            services.AddSingleton(connection);
            
            services.AddOpenTelemetryTracing((builder) => builder
                    .SetResourceBuilder(ResourceBuilder.CreateDefault().AddService(zipkinServiceName))
                    .AddAspNetCoreInstrumentation()
                    .AddHttpClientInstrumentation()
                    .AddRedisInstrumentation(
                        connection,
                        option=>
                        {
                            option.FlushInterval = TimeSpan.FromSeconds(5);
                        }
                    )
                    .AddZipkinExporter(zipkinOptions =>
                    {
                        zipkinOptions.Endpoint = new Uri($"{zipkinEndpoint}");
                    })
                    .AddConsoleExporter());

            return services;
        }
    }	
}
  
API 的 Startup.cs 程式碼說明
  • Line 9 : 新增 Redis instance
  • Line 30 : 設定 redis life cycle
  • Line 36 : 設定 redis 自動蒐集 Library

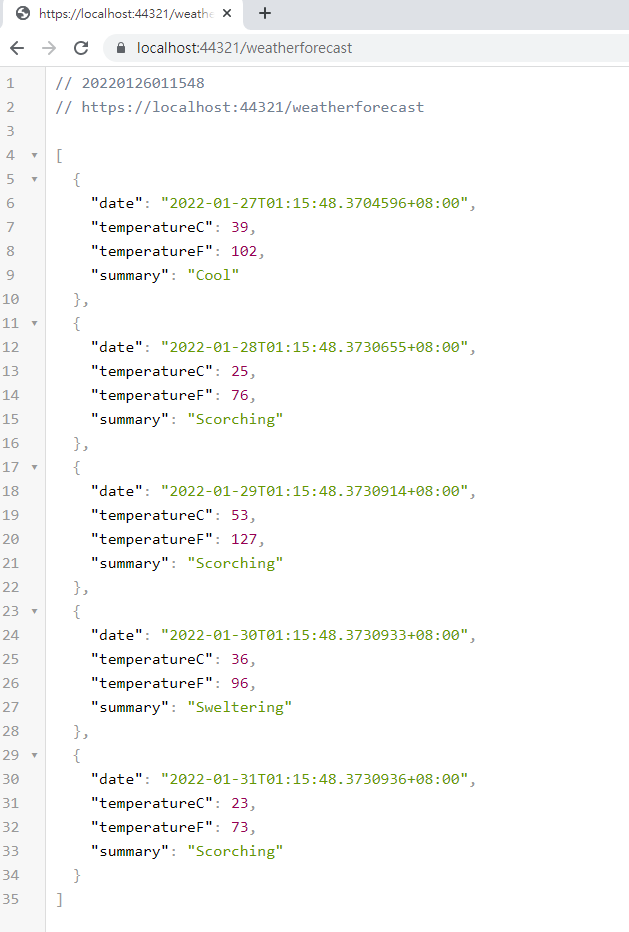
撰寫完代瑪之後,開啟瀏覽器輸入 https://localhost:44321/weatherforecast 進行測試,可以發現有正常的回傳 weather 的資訊

接著在開啟 zipkin 看這次的範例會如何呈現

在 zipkin 中可以看到請求的相關連資訊,整個請求可以分為四個 span 每個 span 所花費的時間都可以透過 zipkin 顯示出來,從 Demo Website 到呼叫 Demo API 再到後面的 Redis 緩存 cache 都一目了然呈現,其中像是點選 localhost:6379 redis 的話,右邊區塊會呈現蒐集 redis 相關的遙測數據資料,舉例來說 redis 的 servicename, endpoint、db.system 都有提供,是透過哪個 library 搜集器的資訊與版本也可以看到。

結論
在過去如果要達到相同目蒐集請求資訊的話,可能在代碼上會加上很多不同的類別,像是要蒐集時間可能會使用 stopwatch 來計算執行時間、定義要蒐集的資訊加上logging,logging 會在加上 tag 或是自定義 attribute 蒐集想要的內容、上述部分如果沒有一個好的規範可能在代碼上就會相對雜亂一些,如果希望規模或一致性會定義蒐集資訊的共用規範或是 library 則需要很大的前置作業與功夫來規範。透過 OpenTelemerey 則可以大大省下這些時間,就像上面範例三的 Demo 內容透過 OTel 提供的 Library 就可蒐集請求的遙測數據資料,並 exporter 到指定的工具或是平台上,在透過自己習慣使用的平台來查詢異常問題的 root cause 或是異常的 service 是哪個,三大雲平台廠商在 OpenTelemetry 規範孵蛋成功後,也開始在自己的平台上陸續支援這套蒐集遙測數據的規範,像是在 Azure 就有在 MSDN 與技術部落格說明 Azure Monitor 與 Application insign 如何整合 OpenTelemetry。

這篇文章的範例與程式碼在 Github 上都可以看的到,位置是 OpenTelemetrySample with .NET Core,各位有興趣的朋友都可以 Clone 專案下來在自己的本機環境試試看,hope it help :D

參考
https://opentelemetry.io/

2022年1月15日 星期六

[OpenTelemetry] 現代化監控使用 OpenTelemetry 實現 : OpenTelemetry 開放遙測

前言
最近在 suvery 監控相關議題時接觸到 OpenTelemetry 蒐集遙測數據的開源框架,覺得這議題挺有趣的因此整理變成系列文,這篇是研究 OpenTelemetry 的系列文第二篇, 這系列主要會分為四篇分別是 若對於上述內容有問題或是不清楚的地方,歡迎提出來一起討論

Telemetry
Telemetry 這詞是由兩個單字所組成,分別是 Tele(遠程) 與 Metron(測量),意思是「遙測」,是指在遠端蒐集測量值或是數據資料,在將其蒐集到的資料自動傳輸到接收端進行監控。在軟體可能過去比較少聽到這詞,但在其他產業項是醫療或是汽車已經是很普及的用語,像是如果今天不舒服住院時,護士可能會在你手上擺放貼片,這些貼片會將身體的資料量是脈搏、血壓等資訊透過病床旁邊的儀器,在送到相同樓層的護理站,當有異常或是心跳部正常時就會透過數據進行遠端監控,確保身體狀況是 OK 沒問題的;在汽車業可能是當車進車廠保養時,維修技師即可透過線插入設備後即可了解車目前的狀況如何,哪邊可能是有意常要注意要修理的。

OpenTelemetry
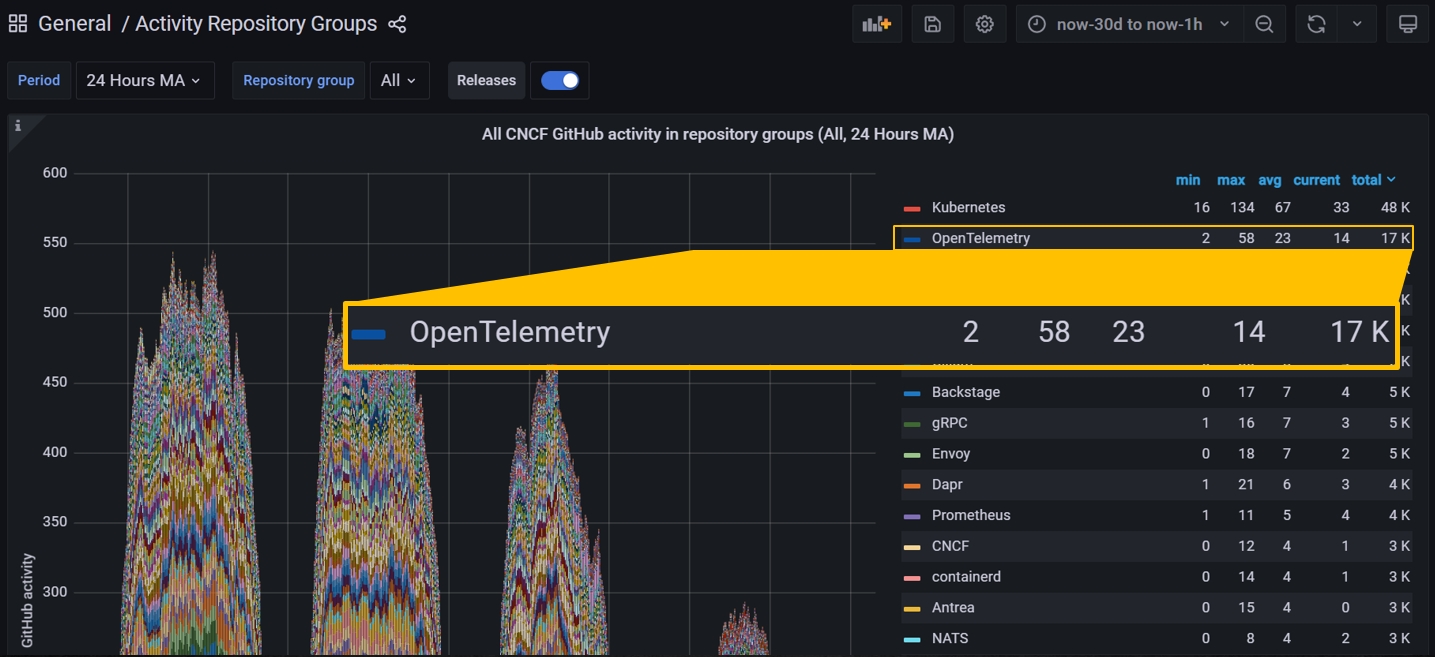
圖片來源 : CNCF Dev Status

熱門開源框架
從 CNCF (Cloud Native Computing Foundation) 所提供的查詢網頁可以看的到,OpenTelemetry 是 CNCF 中第二個活耀的 Open source 項目(僅次於 K8S),最近微軟在推的 Dapr 也是使用 OpenTelemetry 作為內建的蒐集數據基礎 ,到底 OpenTelemetry 是什麼 ? 可以在這幾年可以竄升的這麼快,這麼火紅呢 ? 我們先來了解一下過去是怎麼做的以及有哪些解決方案

過去是如何蒐集遙測數據的呢
圖片來源 : Construction and Operation of Observability Platform using Istio
在過去分散式追蹤 (Distributed Tracing) 較著名有 OpenCensus 及 OpenTracing 框架,各自有所定義的規範及實作的內容,透過以上圖可以清楚了解 OpenCensus、OpenTracing 及 OpenTelemetry 之間的關係,在過去 Google 在內部是透過自己開發的 Dapper 系統進行進行分散式追蹤問題確認,在 2016 年提出 OpenCensus 作為分散式追蹤及監控規範標準;同一年 CNCF 提出 OpenTracing 分散式追蹤的標準,提供廠商中立的 API 且在多種程式語言均有實現可以使用。兩種分散式追蹤規範有各自的標準與定義的 API,有各有各的擁護者與愛好者(沒有絕對的好壞)。在 2019 年由多間軟體大廠共同合作下制定了 OpenTelemetry,OpenTelemetry 取代了 OpenCensus 及 OpenTracing 成為新一代的遙測數據蒐集標準。

從官網的介紹摘要如下
 OpenTelemetry 是雲原生(Cloud Native) 的可觀測性(Observability)框架,提供了標準化的 API、SDK 與協議自動檢測、蒐集和導出遙測數據資料(Metric、log、Trace),支援 W3C 定義的 Http trace-context 規範,降低開發者在蒐集遙測數據上的困難度,方便後續進行分析與了解應用程式的性能與行為,。
OpenTelemetry 是由 CNCF (Cloud Native Computing Foundation) 組織孵化的開源專案,2021/5 通過由 OpenTracing 與 OpenCensus 兩個框架合併,結合兩項分散式追蹤框架重要的特性成為下一代收集遙測數據的新標準,並在 2021/8 月時 OpenTelemetry 進入孵化階段(狀態頁)。

核心元件
在 OpenTelemetry 中核心如下
  • API : 開發人員可以透過 OpenTelemetry API 自動生成、蒐集應用程式(Application)的遙測數據資料(Metrics, Log, Trace),每個程式語言都需實作OpenTelemetry 規範所定義的 API 方法簽章。
  • SDK : SDK 是 OpenTelemetry API 的實現
  • OTLP : OTLP 規範定義了遙測數據的編碼與客戶端及服務器之間如何交換的協議 (gRPC、HTTP)
  • Collector : OpenTelemetry 中儲存庫,用於接收、處理、導出遙測數據到各種後端平台

Context Propagation
OpenTelemetry 其中一個重要的功能為 Context Propagation,甚麼是 Context Propagation 呢 ? 這是在 Trace 中一個相當重要的特性,當今天你的系統架構服務(Service)越切越細時,Client 發出一個請求可能 Response 會由多個資料來源所組成,也藉意味著當今天如果其中一個資料來源緩慢時就可能整個 Response 都會受到影響,透過 Trace 可以得知這多個資料來源是哪一個緩慢所影響,以下圖為例
系統中最小的單位叫做 Span,透過上圖可以得知是由 Span A 資料來源會是 Span B 及 Span C,Span B 資料來源為 Span D,Span C 的來源會是 Span E 與 Span F (G、H 暫省略),也就意味著 Span C 是 Span E 與 Span F 的上一層。某個請求從進入到回傳整個過程叫做 Trace,那麼我要如何知道 Span A~H 是相關聯的呢 ? 每個 Span 都會有兩個重要的 ID 分別是 SpanId 與 TraceId, SpanID 是每個 Span 各自都會擁有的 ID, TraceID 整串會是相同的 ID 值,這樣在追蹤上就可以透過 TraceID 來將有關聯的 Span 串起來。在上圖所示 Span A~H 這整串的 TraceID 會在相同的,其 ID 值會是 Span A 的 SpanID。
接著再繼續來看,光透過 SpanId 與 TraceId 是沒有辦法得知各自 Span 異常或是緩慢資訊的,在 Span 其實還有蒐集很多相關的內容,以下圖為例這會是 當請求來 SpanB 背後所收集的資訊,可能會把發送到 Server 的 request / response 以及 server 的回應內容,以及所花費的時間記錄下來,才可以透過這些已知已知的訊息找出哪一個服務緩慢,需要服務下線或者是做一些進一步的調整。
Support
OpenTelemetry 是蒐集遠端遙測數據的規範及標準,在目前既有有名的程式語言中都有實作 OpenTelemetry 的開源框架。另外在 Collector 上一些 OpenSource 像是 Grafana 與 Zinkin && Jaeger 現在都支援。詳細要看目前支援什麼 Language、Instrumentation、Exporter 可以到官方網站 Register 自行搜尋。

結論
這篇主要在介紹 OpenTelemetry 的前世今生,解決什麼問題與 Trace 中重要的觀念 Context Propagation,最後在帶到目前支援的程式語言,那麼 OpenTelemetry 規範在 NET 是如何實作的呢 ? 下一篇我將分享在 NET 中如何使用 OpenTelemetry API 以及一些 Demo Code 讓大家可以更容易進入 OpenTelemetry,謝謝


參考
https://opentelemetry.io/

2022年1月1日 星期六

[OpenTelemetry] 現代化監控使用 OpenTelemetry 實現 : 可觀測性(Observability)

前言
最近在 suvery 監控相關議題時接觸到 OpenTelemetry 蒐集遙測數據的開源框架,覺得這議題挺有趣的因此整理變成系列文,這篇是研究 OpenTelemetry 的系列文第一篇, 這系列主要會分為四篇分別是 若對於上述內容有問題或是不清楚的地方,歡迎提出來一起討論

企業面臨的挑戰
隨著科技技術不斷的創新,軟體架構與基礎建設演變速度也是變化相當快,如下圖所示可能(但不限)於以下幾個階段
  • 第一階段 :應用程式架構設計上較為簡單,在商業需求沒那麼複雜架構上不會針對其模組做太多的切割,程式會運行執行緒(Process)執行單一的請求,在進行測試與問題排除上較為簡單;在開發完畢之後會佈署在 VM 或是會 IDC 機房中提供給使用者來使用。
  • 第二階段 :隨著雲端技術的推出,企業開始嘗試將應用程式佈署到雲端的 Iaas 服務上,或是結合公有雲與私有雲的優勢,將企業中機密資料在私有雲進行處理,其他資訊在公有雲服務上進行運算,開發人員在應用程式的開發與整合上有更多與 Cloud 服務整合的機會,選擇 Cloud 上適合的服務使用。
  • 第三階段 :雲端技術逐漸成熟與穩定,更多的雲端基礎建設服務與新服務不斷的推出,在架構設計上越來越多人開始討論分散式系統架構的設計,也越來越多人考慮將資料庫從IDC機房遷移到 Cloud 雲端上,加上像是 RDS、DynamoDB、Redis 等雲端資料庫, 這些服務或組件讓大家在雲端開發與管理上更為方便。在架構上也更為彈性搭配著企業需求來使用;在基礎建設上也伴隨著容器化(dockerize)的技術成熟開始進入新的世代。
  • 第四階段 : 過去幾年大家一直在討論軟體架構從單體到微服務 serverless、service meshes 等各種可能的組合,主要目的可能是在服務架構設計時如何降低服務之間的依賴關係;在越來越多企業使用虛擬容器技術 Docker 後發現管理 Docker 實務上是困難的,因此 Kubernetes(K8S) 開始盛行,幫助團隊在調度 Docker 上更為容易與靈活,

但與所有美好事物一樣都是有代價的;當服務越切越細時,分佈式系統帶來了眾多的挑戰。當開發的世界變得複雜,可能會帶來哪些影響呢 ? 可能會分為三個部分:
  • 架構 : 從單體式架構 > SOA > 分散式架構 > 微服務 開發人員在開發上變得更繁瑣,要注意的事情變得更多。例如 : 服務彼此之間的溝通要如何進行 ? 在事件的紀錄上要如何處理 ? 當一個請求要經過多個服務的時候相對的延遲(Lateny)也會增加,服務的拆分與請求時間的部分該如何達到平衡 ?
  • 測試 : 當系統架構變得複雜,測試人員或團隊在測試上勢必需要花更多時間來了解既有架構要如何進行測試。
  • 監控 : 上線後的監控會是最大的挑戰,當你所在的產品服務是 7* 24 小時,系統架構切分很細或是很複雜時,當今天某個服務故障時要如何快速定位問題變的是重要的關鍵

案例: Facebook 當機事件
圖片來源 : https://3c.ltn.com.tw/news/46163
或許上面文章提到的部分有點抽象,我們來看一個真實的案例,2021/10/4 facebook、whatApp及 IG 大當機,整個案件根本原因是因為工程師在部署新功能時有錯,導致對外 DNS 服務異常,詳細可以看 facebook 官方技術部落格或 Cloudfare 的異常事故報告 說明。
這裡簡單整理事件造成的影響:
  • 修復時間 : 從問題開始到最後修復完成近花費 6 小時
  • 影響人數 : 八千萬人無法使用
  • 損失金額 : 10 億台幣
  • 影響股價 : 問題發生後,股票下跌 4.89 %
最重要的可能是客戶滿意度,你可以想像一下今天剛好忙碌一天想滑一下手機看 IG、facebook 或是 whatApp 找朋友聊天時,但發現這些服務都沒有辦法使用心情會是如何 ? 使用者可能會跑去使用其他服務,facebook 官方在服務異常地當下也在 twitter 發文說明問題與處理的狀況,隨著時間一分一秒的過去,客戶逐漸地在流失到其他服務像是 twitter,廣告主投放的廣告也無法正常投放。

從上述問題來看,如何讓問題發生時能夠快速地被定位變得更加重要,在企業服務越切越細的世代,最快時間找到問題變得相當的關鍵。如果今天是發生在你的公司或是負責的系統發生異常時,你要如何快速的定位問題呢 ?

圖片來源 : https://trends.google.com.tw/trends/?geo=TW
根據 Google 關鍵字報告搜尋 監控(Monitor) 關鍵字,可以發現在過去 20 年的時間大家對於應用程式的監控越來越重視,背後的涵義可能是在這變化這麼快、不確定性這麼高、架構越來越複雜的時代,是否有更好的方法或方式來進行監控,或者也可以反問,或許在雲原生(Cloud Native)時代的監控,應該具備甚麼樣的特性?


可觀測性(Observability)
分散式系統意味者分散式故障,當出現故障時,可能很難快速恢復服務,甚至不知道從哪裡開始。您如何解析龐大的依賴關係,取決於你對系統的了解與問題定位有很大的關聯。可觀測性簡單來說可以幫助開發人員或是 SRE 夥伴了解,什麼是慢的 ? 什麼是壞的 ? 以及需要做什麼來提高性能。
可觀測性三個重要的特性
  • Metrice : 系統有狀況
  • Logs : 問題是甚麼
  • Traces : 哪裡出問題
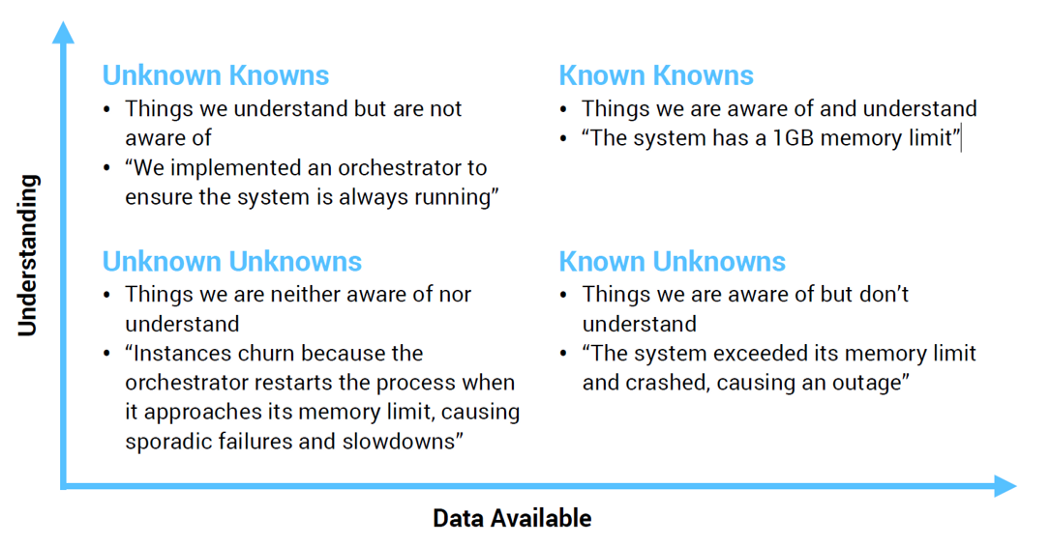
過去監控可以解決的是已知的已知問題,可觀測性要解決的是已知的未知的問題,那麼什麼是已知的未知呢 ?
圖片來源 : https://dzone.com/articles/microservice-observability-part-1-disambiguating-o
橫軸 : Data available, 指的你是否有 log 的資料
縱軸 : 對於系統的理解程度

接者可以透過橫軸縱軸了解的程度切分為四個象限,可能光看文字會有點抽象,以下透過一些簡單的例子舉例說明
  • known knowns : 這些事情是我們知道且可以理解的,舉例 : 在雲端伺服器建立新的 instance 時,核心數為 1 core,記憶體為 1G 可以提供應用程式使用。
  • known Unknowns : 事情是我們知道但沒辦法理解的,舉例 : 應用程式接收到多大的請求量時,系統會 crash 造成服務中斷;電商遇到雙11節慶流量會很大,但我們不確定請求量會成長幾倍?
  • Unknown Knowns : 事情是我們知道但自己是沒有意會到的
  • Unknown Unknowns : 不了解會發生甚麼事以及其帶來的影響,舉例 : 不了解系統在高流量時會發生甚麼問題,也不清楚會有哪些服務會被影響到

圖片來源 : https://dzone.com/articles/microservice-observability-part-1-disambiguating-o
右下角就是過去常常聽到的監控(Monitoring),知道可能會異常的點會有那些因此加上偵測點進行判斷,如果超過其筏值或是水位值會發送告警通知。左下角是可觀測性(Observability),希望可以透過已知的訊息更了解系統的狀況。

可觀測性(Observability) 的目的是什麼呢 ?
可觀測性不僅僅是收集數據的內容,希望透過可觀測性工具或平台可以回答下列問題:
  • 請求通過了哪些服務
  • 每個服務在處理請求時做了什麼
  • 如果請求很慢,瓶頸在哪裡
  • 如果請求失敗,錯誤發生在哪裡
  • 請求的關鍵路徑上是什麼
  • 執行與正常系統行為有何不同
  • 為什麼花了這麼長時間
我們可以透過追蹤(Traces)的方式來蒐集或得到上述問題的答案。

Distributed Tracing
圖片來源 : https://eng.uber.com/optimizing-observability/
過去大家常提到的監控(Monitor)是透過 Metrics 及 Log 來達到其目的,可觀測性(Observability) 更著重在追蹤(Trace)的部分,Trace 的目的是把系統中所有模組與組件之間的交互關係透過 TraceID 串聯起來,TraceID 是請求(Request)開始生成一個關聯ID,接著再將其記錄在該事務(Span)的每個請求中,可以讓你知道一個請求或是某個事件從頭到尾的信息內容,也就是透過上下文關係(Context)來取得請求中各服務之間的關聯。

舉例來說,以上圖內容為例,當使用者發送一個請求來的時候,從 A 點服務開始,接著分別經過 B、E 兩個服務,B 的服務資料來源是透過 C 與 D 的服務取得,以及這些服務各自所花費的時間為何。當我們蒐集到每個服務的資訊與所花費的時間,發現請求有緩慢或是服務異常的問題時,監控團隊可以透過遙測的數據定位可能異常的服務來進行問題排除與處理,加快可能異常服務的問題確認時間。

結論
可觀測性是這幾年新的術語,今天簡單介紹了可觀測性(Observability)的目的,關鍵核心是透過 Traces 提供系統行為及上下文關係,那麼在實務上要如何蒐集這些數據資料呢 ? 下一篇我們將分享如何使用 CNCF(Cloud Native Computing Foundation) 的 Open Source 框架 OpenTelemetry 來蒐集遠端遙測數據資料,讓你的系統更具備可觀測性(Observability)。


參考
Monitoring in the time of Cloud Native Microservice Observability, Part 1: Disambiguating Observability and Monitoring

Copyright © m@rcus 學習筆記 | Powered by Blogger

Design by Anders Noren | Blogger Theme by NewBloggerThemes.com